모델 출시 다음 날, 플랫폼 책임자 두 사람이 앉았습니다
케이틀린 레세(Katelyn Lesse)와 앤절라 지앙(Angela Jiang)은 앤트로픽에서 개발자가 Claude를 자기 제품에 붙여 쓰는 API와 플랫폼에서 각각 엔지니어링과 제품을 총괄합니다. 10월 27일 공개된 Latent Space 대담은 Claude Opus 5.5가 나온 다음 날 녹화됐고, 진행자 스윅스(swyx)는 앤트로픽의 상장 신고서(S-1)를 짚으며 대화를 열었습니다. 상장을 앞둔 앤트로픽을 연달아 다루는 기획의 한 편이었습니다.
이 대담은 말하는 사람의 위치 때문에 들어 볼 만합니다. 모델을 만드는 회사 안에서 그 모델을 바깥으로 내보내는 통로를 운영하는 사람들이, 출시 직후의 기억으로 일하는 방식을 이야기했습니다. 1시간 47분 가운데 이 글은 논지 세 개만 고르고 나머지 지면은 그 논지가 한국 조직에서 어떻게 읽히는지에 씁니다. 영어 인용은 대담 원문 그대로이고, 옆의 시각을 누르면 해당 장면으로 이동합니다.
출시 · 재작성 · 보안에서 사람이 쥔 것
첫째, 출시 업무의 무게가 안전 장치로 옮겨 갔습니다. 레세에 따르면 이제 출시 작업의 대부분은 증류(다른 회사가 모델의 답을 대량으로 받아 자기 모델을 학습시키는 일) 방지, 실시간 · 사후 안전 장치, 모델별 정책 결정입니다. 공개 전에는 여러 버전을 사내에서 먼저 써 보고, 자체 평가 세트를 갖춘 고객에게 사전 체험판을 냅니다. 어떤 피드백이 도움이 되느냐는 질문에 돌아온 답은 짧았습니다.
솔직히 가장 쓸모 있는 피드백은 부정적인 피드백입니다.
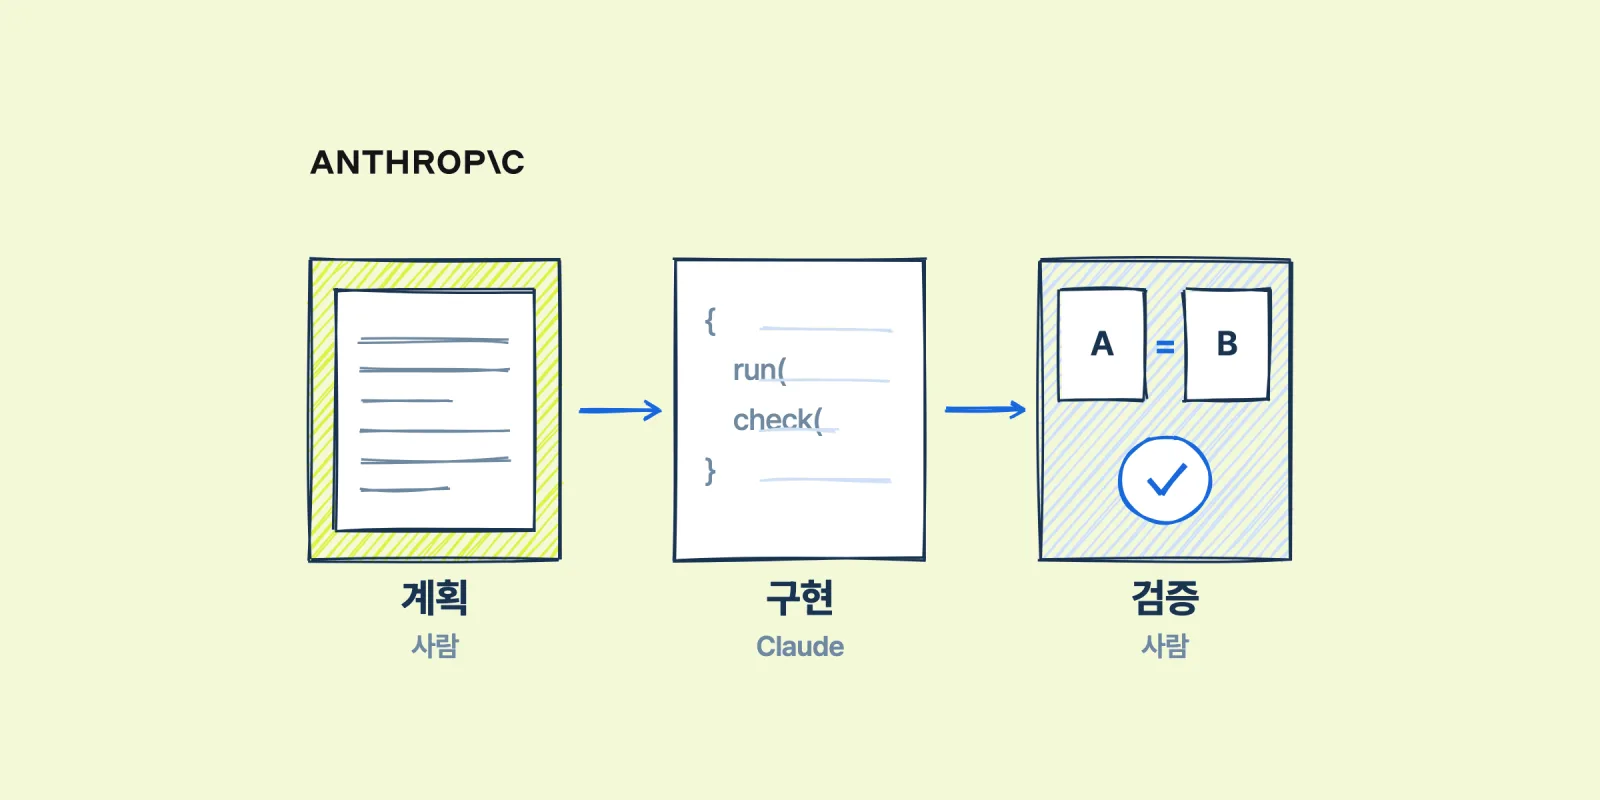
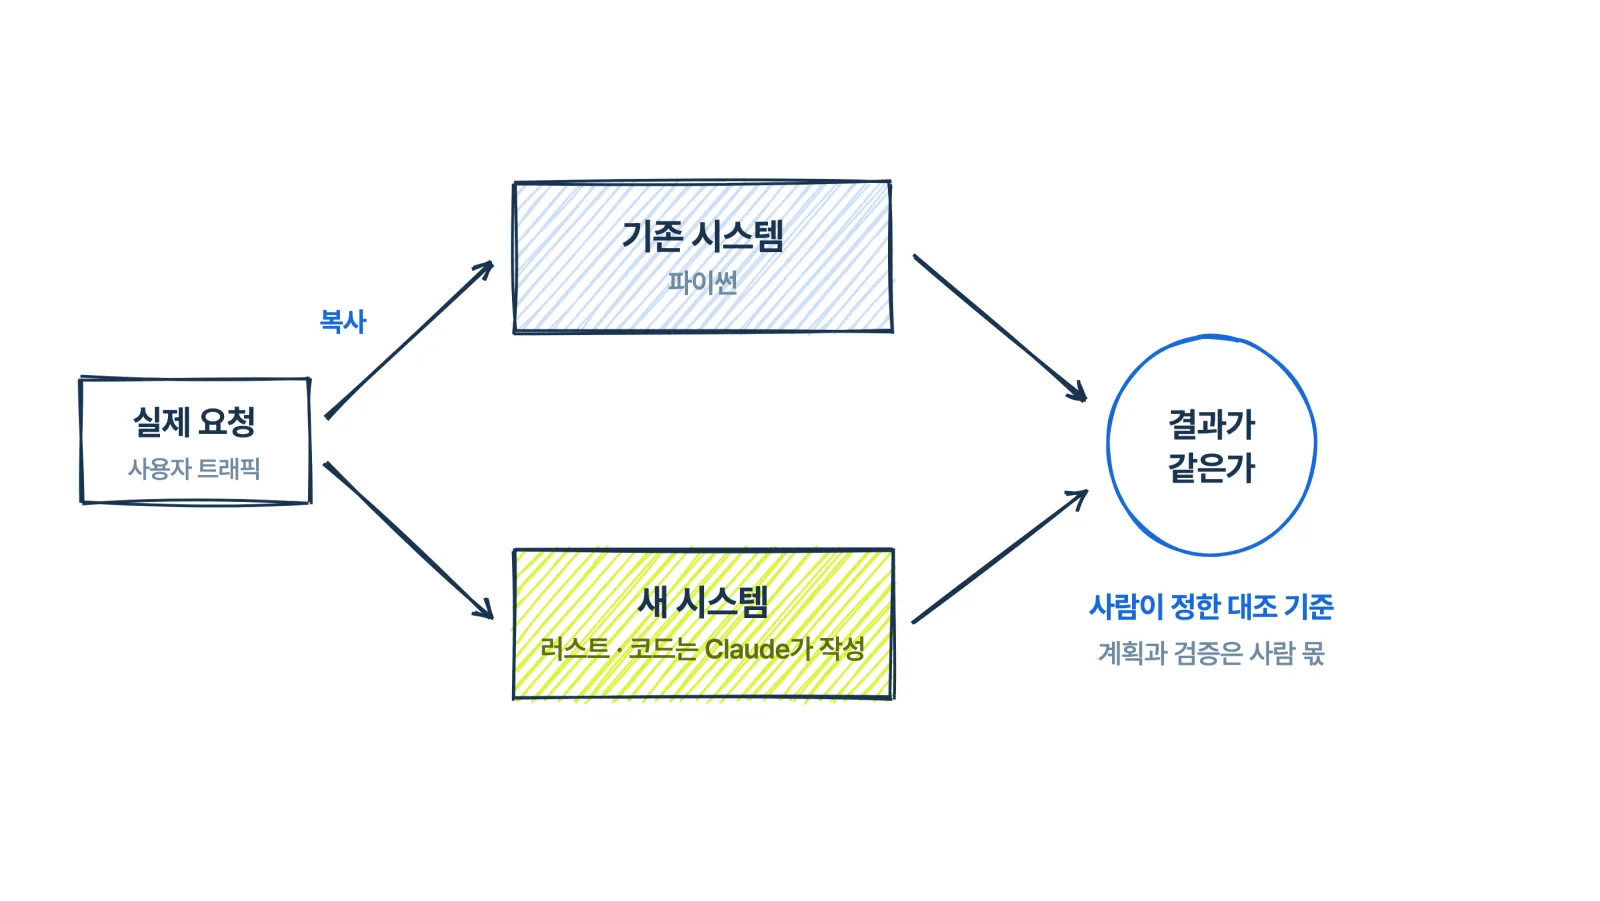
둘째, 코드는 Claude가 썼고 사람은 계획과 검증을 맡았습니다. 팀은 메시지 API를 파이썬에서 러스트(Rust)로 통째로 옮겼습니다. API 전체를 러스트로 따로 만든 뒤 실제 요청을 복사해 두 시스템에 함께 흘리고 결과를 대조하는 방식이었습니다. 레세는 CPU를 40~50% 아꼈고 첫 응답까지의 시간이 10~20% 줄었다고 어림했습니다.
가장 중요했던 두 가지는 무엇을 할지 세운 계획과 그 결과를 확인하는 검증이었습니다. 실제 구현은 Claude가 코드를 쓰는 일이었으니까요.
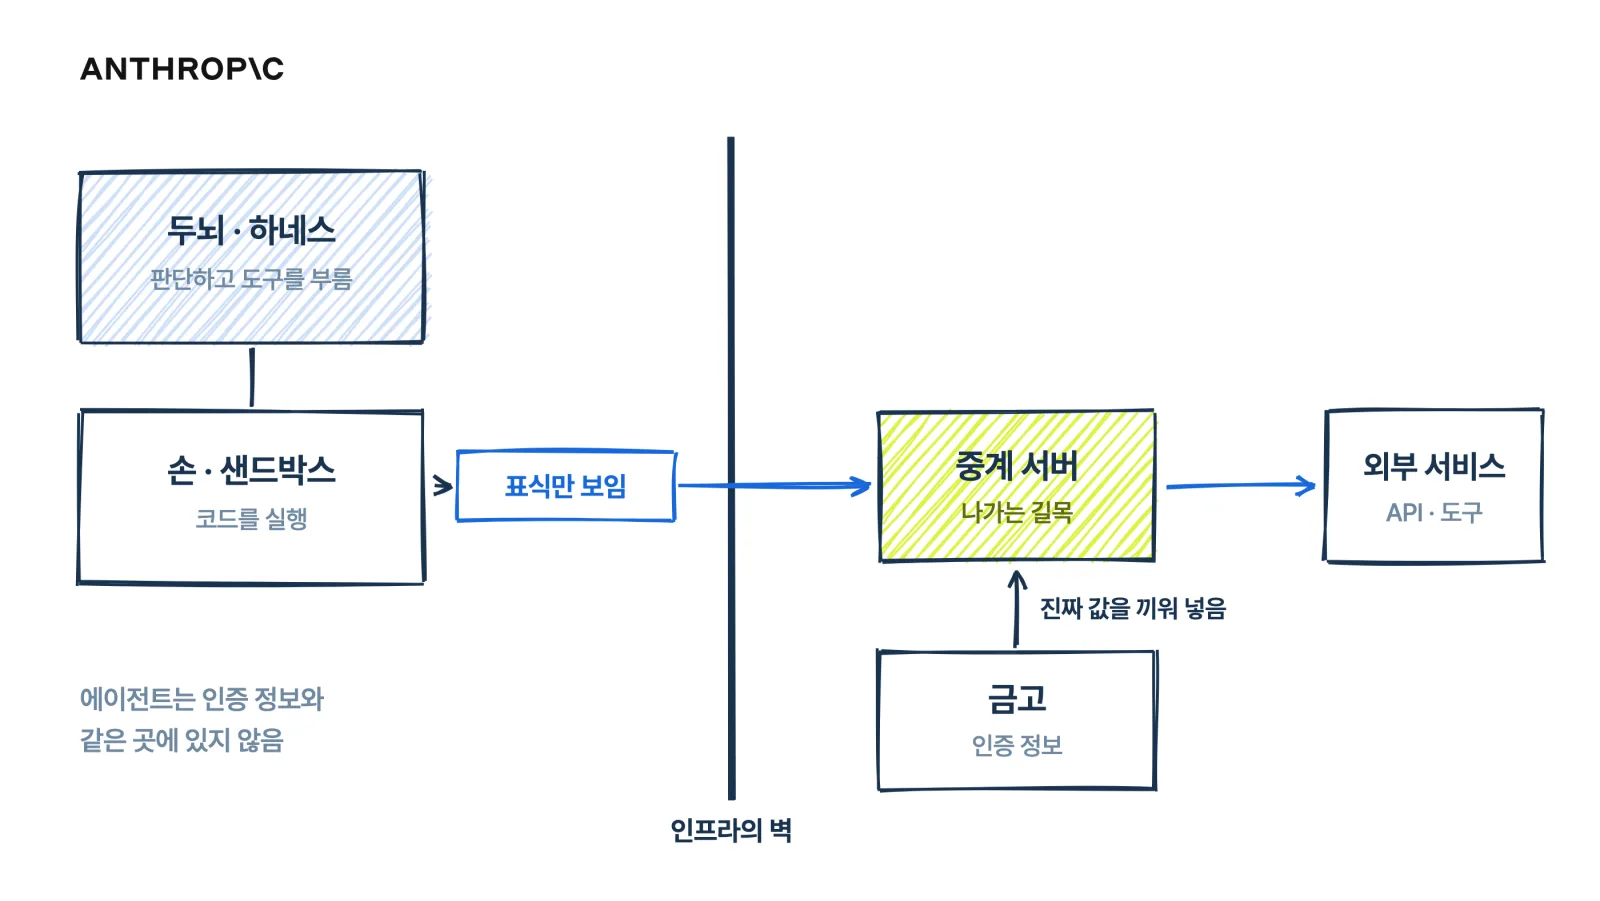
셋째, 에이전트의 두뇌와 손을 떼어 놓았습니다. Claude Managed Agents는 판단하고 도구를 부르는 틀(하네스)과 코드를 실행하는 격리 공간(샌드박스)을 나눠 둡니다. 처음에는 안정성과 응답 속도 때문에 나눴는데, 지금은 보안을 이 구조의 중요한 성질로 꼽습니다. 외부 서비스용 인증 정보는 별도 금고에 있고 에이전트에게는 표식만 보입니다. 요청이 밖으로 나가는 길목에서 중계 서버가 진짜 값을 끼워 넣습니다.
에이전트는 인증 정보가 있는 곳에 함께 있지 않습니다.
한국 조직에서는 판정 기준에서 먼저 걸립니다
세 논지는 한 방향을 가리킵니다. AI가 실행을 넓게 맡을수록 사람은 무엇을 맞다고 볼지 정하는 일에 붙습니다.
다만 대담은 이 방식이 서는 전제를 따로 말하지 않습니다. 앤트로픽에는 이미 두꺼운 평가 묶음이 있고, 같은 요청을 두 시스템에 흘려 볼 인프라가 있으며, 체험판을 받자마자 평가를 돌려 주는 고객이 있습니다. 진행자가 농담처럼 토큰 비용 이야기를 꺼냈듯, 모델을 쓰는 비용에 대한 감각도 일반 기업과 다릅니다. 이 전제를 빼고 결론만 가져오면 「사람은 검증만 하면 된다」는 말이 남는데, 검증할 기준이 없는 조직에서 그 말은 공허합니다.
노바폴드가 현장에서 보는 첫 번째 걸림돌은 기술보다 판정 기준입니다. 많은 조직에서 AI 결과물의 검토는 결재선을 따라 올라갑니다. 결재권자에게 승인 권한은 있지만, 무엇이 맞는 결과인지 미리 적어 둔 기준은 대개 없습니다. 기준 없이 검토하면 결국 사람이 결과물을 처음부터 다시 읽게 되고 AI로 아낀 시간은 검토 단계에서 고스란히 사라집니다.
검토가 결재로 바뀌면 묻는 말도 달라집니다. 「이 결과가 맞는가」 대신 「이 결과를 내보내도 되는가」를 묻게 되고, 판단은 결재권자의 경험에 기댑니다. 경험 많은 사람이 보면 품질은 지켜지지만, 그 사람이 바쁘면 검토 전체가 멈춥니다. 기준을 글로 적어 두어야 검토를 여러 사람에게 나눌 수 있고 나중에는 그 기준과의 대조를 AI에 먼저 맡길 수도 있습니다. 앤트로픽이 갖춘 평가 묶음도 결국 글로 적힌 기준입니다.
가상의 예를 하나 들겠습니다. 한 보험사가 상품 약관 비교표를 AI로 만드는 과제를 시작했다고 합시다. 앤트로픽식으로 하려면 착수 전에 정답이 확인된 비교표 수십 장을 먼저 모으고, 새 결과를 그 정답과 대조하는 절차부터 둬야 합니다. 그런데 이 준비는 AI 도입 예산에 잘 잡히지 않고 맡을 부서도 흐릿합니다. 틀린 비교표가 몇 장인지 셀 방법이 없으니 담당자는 시연 화면의 인상으로 판단하게 되고, 과제는 시연까지 간 뒤 운영 앞에서 멈춥니다. 실제 회사 사례가 아니라 설명을 위해 꾸민 상황입니다.
첫 번째 논지에서 가져올 것은 시범 부서를 고르는 기준입니다. 사내에 AI 도구를 시범 도입할 때 많은 조직은 의욕이 높은 부서나 목소리가 큰 부서를 먼저 고릅니다. 앤트로픽이 사전 체험판을 내주는 고객은 그와 다릅니다. 결과를 판정할 평가 세트를 이미 갖고 있어서, 무엇이 안 되는지 곧바로 말해 줄 수 있는 곳입니다. 부정적인 피드백이 가장 쓸모 있다는 말은 이 선별 기준이 있어야 성립합니다. 칭찬만 돌아오는 시범 운영은 다음 판단에 쓸 정보를 거의 남기지 않습니다.
러스트 이전 사례에도 대담이 짚지 않은 전제가 있습니다. 앤트로픽은 계획을 세운 팀과 검증을 맡은 팀, 운영하는 팀이 한 조직 안에 있습니다. 한국에서는 시스템 개발을 외부 업체에 맡기는 경우가 많고, 이때 계획은 발주 문서에, 검증은 납품 검수에 흩어집니다. AI가 코드를 쓰는 비중이 커질수록 발주사가 직접 쥐어야 할 것은 검수 기준과 대조 데이터입니다. 이것까지 외부에 넘기면 사람이 맡아야 할 두 가지가 모두 조직 밖으로 나갑니다.
두 번째 걸림돌은 돌려보낼 권리입니다. 대담 후반에 앤트로픽 팀은 AI로 만든 결과물을 받은 사람이 수준 미달이라고 판단하면 그냥 돌려보내라고 권한다고 말했습니다.
정말 대충 만든 결과물이라면 돌려보내세요. 아니라고 말하고 돌려보내면 됩니다.
위계가 분명한 조직에서 상급자나 다른 부서가 넘긴 결과물을 돌려보내기는 쉽지 않습니다. 이 권리를 규칙으로 적어 두지 않으면, 받은 사람이 남의 AI 결과물을 조용히 고쳐 주는 일이 반복됩니다. 겉으로는 생산성이 오른 것처럼 보여도, 실제로는 검토 부담이 직급이 낮은 쪽으로 쏠립니다.
돌려보낸 건수와 사유를 기록해 두면, 어떤 업무에서 AI 결과물이 자주 기준에 못 미치는지도 함께 보입니다.
세 번째 논지는 오히려 한국 조직에 잘 맞습니다. 망분리와 보안 심사에 익숙한 조직일수록 「에이전트가 인증 정보를 직접 볼 수 있는가」라는 질문을 이해하기 쉽습니다. 에이전트 도입을 심사할 때 모델 성능보다 이 질문을 먼저 던지면, 보안 부서와 현업이 같은 그림을 놓고 이야기할 수 있습니다.
그렇다고 모든 조직이 같은 금고와 중계 서버를 직접 지을 필요는 없습니다. 대담이 설명한 것은 앤트로픽이 자기 플랫폼에 만든 구조입니다. 도입하려는 에이전트 서비스가 인증 정보를 어디에 보관하는지, 코드가 실행되는 공간과 그 정보가 떨어져 있는지를 공급사에 묻는 것으로 시작하면 됩니다. 답이 흐릿하다면 그 서비스는 아직 업무 시스템에 붙일 단계가 아닙니다.
판정할 수 없는 일은 아직 맡긴 일이 아닙니다
대담에서 두 사람이 보여 준 것은 AI에 일을 많이 넘긴 조직이 아니라, 넘긴 일의 결과를 판정할 장치를 먼저 깔아 둔 조직이었습니다. 사전 체험 고객, 두 시스템 대조, 인증 정보 금고는 모두 그런 장치입니다. 장치가 먼저 있었기에 맡기는 범위를 과감하게 넓힐 수 있었습니다.
한국 조직의 AI 논의는 흔히 어떤 모델을 쓸지, 일을 얼마나 줄일지에서 시작합니다. 이 대담은 그 순서를 뒤집어 보라는 제안으로 읽힙니다. 무엇을 맞다고 볼지 먼저 정하고 그 기준을 통과하는 만큼만 넘기는 순서입니다.
AI 도입의 속도는 모델 성능만으로 정해지지 않습니다. 조직이 판정 기준에 얼마나 빨리 합의하느냐가 더 크게 작용합니다. 지금 우리 조직이 AI에 넘긴 일 가운데, 성공 기준이 글로 적혀 있는 일은 몇 개입니까?
참고
- How Anthropic ships the #1 LLM in the World safely: Separating the Brain from the HandsLatent Space 에피소드 페이지 · 2026.10.27
- Scaling Managed Agents: Decoupling the brain from the handsAnthropic 엔지니어링 블로그 · 2026.04.08